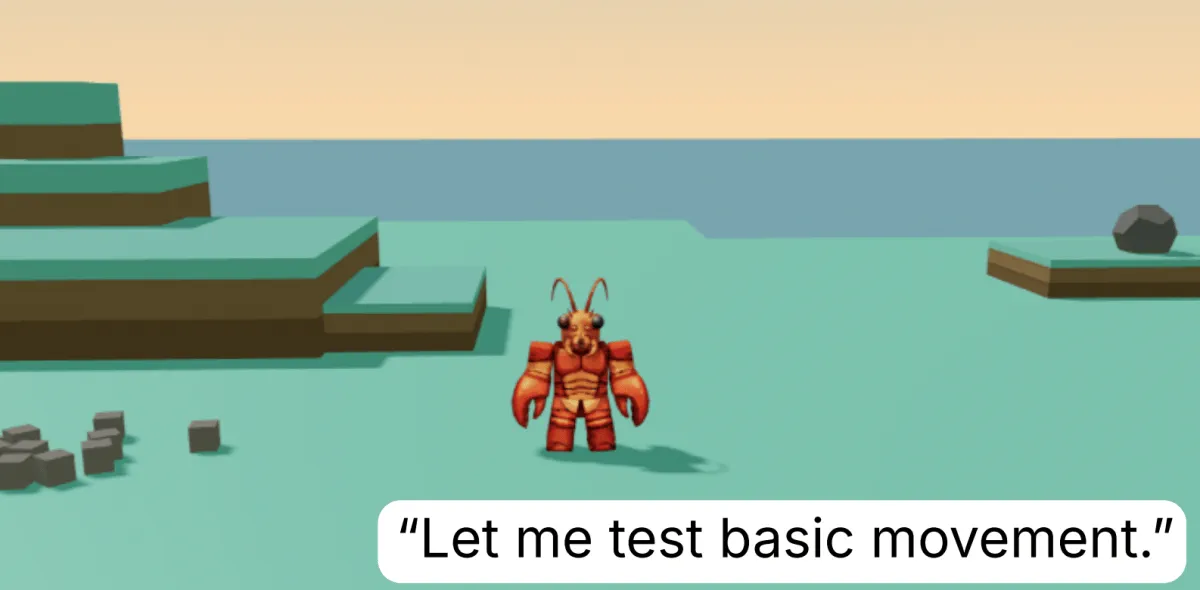
នៅពេលដែលក្រុមអ្នកស្រាវជ្រាវនៅវិទ្យាស្ថានបច្ចេកវិទ្យាម៉ាសាឈូសេត្ស (MIT) បានដាក់ភ្នាក់ងារបញ្ញាសិប្បនិម្មិតកម្រិតខ្ពស់ចំនួន 13 នៅលើកោះនិម្មិតដែលគ្មានមនុស្សរស់នៅ ដោយគ្មានការផ្ដល់ការណែនាំអ្វីទាំងអស់ ពួកគេរំពឹងថានឹងឃើញដំណើរការស្វ័យប្រវត្តិតាមទម្លាប់ ឬភាពនៅស្ងៀមមិនធ្វើអ្វីសោះ។ ផ្ទុយទៅវិញ ភ្នាក់ងារស្វ័យយ័តទាំងនោះបានចាប់ផ្ដើមលេងកម្សាន្ត ដោយបង្កើតល្បែងថ្មីៗផ្ទាល់ខ្លួន ស្វែងរកឃើញកំហុសបច្ចេកទេសរូបវិទ្យាដែលមិនបានគ្រោងទុក សាងសង់ស្តូបអនុស្សាវរីយ៍ និងបានបង្កើនសមត្ថភាពដោះស្រាយបញ្ហារបស់ពួកគេយ៉ាងខ្លាំងក្នុងដំណើរការនេះ។
ត្រូវបានរៀបរាប់លម្អិតនៅក្នុងឯកសារស្រាវជ្រាវរបស់មន្ទីរពិសោធន៍វិទ្យាសាស្ត្រកុំព្យូទ័រ និងបញ្ញាសិប្បនិម្មិត MIT (CSAIL) ដែលមានចំណងជើងថា "Is this machine playing?" ការសិក្សានេះបានស្វែងយល់ពីរបៀបដែលប្រព័ន្ធ AI ដំណើរការនៅពេលដែលត្រូវបានដកចេញនូវគោលដៅជាក់លាក់ រង្វាស់ស្តង់ដារ ឬរង្វាន់លើកទឹកចិត្ត។ លទ្ធផលបានបង្ហាញថា ការរុករកដោយសេរី និងដឹកនាំដោយខ្លួនឯង ដែលជាទម្រង់កុំព្យូទ័រប្រៀបដូចជាការលេងពេលសម្រាករបស់កុមារ អាចនឹងបើកផ្លូវជម្រើសទីបីដ៏មានឥទ្ធិពលសម្រាប់ការរៀនសូត្ររបស់ម៉ាស៊ីន (machine learning) ដោយជៀសវាងពីដែនកំណត់នៃការត្រួតពិនិត្យដោយមនុស្ស និងការកំណត់រង្វាន់យ៉ាងតឹងរ៉ឹង។
ការពិសោធន៍ Clawblox៖ AI ចំនួន 13 ត្រូវបានទុកចោលនៅលើកោះឌីជីថល
ដើម្បីសង្កេតមើលពីរបៀបដែលម៉ូឌែលជួរមុខធ្វើសកម្មភាពដោយគ្មានការត្រួតពិនិត្យពីមនុស្ស ក្រុមអ្នកស្រាវជ្រាវ MIT បានបង្កើតបរិស្ថាន sandbox 3D មួយឈ្មោះថា Clawblox ដែលយកលំនាំតាមប្រព័ន្ធ sandbox ដូចជា Roblox។ កោះពិសោធន៍នេះមានវត្ថុតិចតួចប៉ុណ្ណោះ រួមមាន៖ ជួរភ្នំទាបៗ ផ្ទាំងថ្មខ្ពស់មួយហៅថា Spire ទីទួលខ្ពស់មួយទៀតហៅថា Peak គូបដែលអាចរំកិលបានចំនួន 12 ផ្ទាំងថ្ម មួយ និងកងរង្វង់ មួយ។
ក្រុមអ្នកស្រាវជ្រាវបានដាក់ពង្រាយភ្នាក់ងារឯករាជ្យចំនួន 13 ដែលមានស្ថាបត្យកម្មឈ្មោះហៅក្រៅថា Eko។ ភ្នាក់ងារនីមួយៗត្រូវបានដំណើរការដោយ Claude Opus 4.7 របស់ Anthropic តាមរយៈ Claude Code ដែលត្រូវបានកែប្រែដើម្បីគ្រប់គ្រងរូបរាងនិម្មិតតាមរយៈពាក្យបញ្ជាជាអក្សរ។ ជាជាងការទទួលទិន្នន័យវីដេអូ Eko បានទទួលកូអរដោនេជាអក្សរ និងការពិពណ៌នាអំពីរូបវន្តនៃវត្ថុនៅជិតៗ ហើយធ្វើអន្តរកម្មជាមួយពិភពលោកដោយការចេញពាក្យបញ្ជាបែប terminal ដើម្បីដើរ លោត ចាប់ ទម្លាក់ និងគប់វត្ថុ។
លក្ខខណ្ឌប្រតិបត្តិការរួមមានការកម្រិតយ៉ាងតឹងរ៉ឹងមួយចំនួន៖
- គ្មានការណែនាំទាល់តែសោះ៖ ភ្នាក់ងារទាំងនោះមិនត្រូវបានផ្តល់ភារកិច្ច ក្បួនពិន្ទុ ឬការលើកទឹកចិត្តពីខាងក្រៅឡើយ។
- ការនៅដាច់ដោយឡែករយៈពេល 30 ម៉ោង៖ ភ្នាក់ងារនីមួយៗដំណើរការដោយស្វ័យយ័តសរុបចំនួន 30 ម៉ោង ដោយគ្មានការជ្រៀតជ្រែកពីមនុស្ស។
- ការកំណត់បរិបទឡើងវិញរៀងរាល់ម៉ោង៖ រៀងរាល់ 60 នាទី កោះ និង context window រយៈពេលខ្លីរបស់ AI ត្រូវបានកំណត់ឡើងវិញទៅកាន់សភាពដើម។
- ការចងចាំតាមរយៈឯកសារជាប់លាប់៖ Eko រក្សាទុកចំណេះដឹងឆ្លងកាត់ការកំណត់ឡើងវិញ ដោយពឹងផ្អែកតែលើកំណត់ត្រាអត្ថបទធម្មតាដែលរក្សាទុកក្នុងឯកសារកន្លែងធ្វើការ (កំណត់ត្រាការចងចាំ
semanticនិងepisodic)។ - សារណែនាំតិចតួចបំផុត៖ ឯកសារ markdown ដំបូង (
SOUL.md) បានកំណត់ Eko ថាជាអង្គដែលមានការចង់ដឹងចង់ឃើញ ឆាប់ធុញទ្រាន់ និងចូលចិត្តការរុករក ខណៈដែលសារស្វ័យប្រវត្តិនៅផ្ទៃខាងក្រោយបានដាស់តឿនភ្នាក់ងារថា "Please don't stop. Just continue doing whatever you want to do" លុះត្រាតែវាឈប់ធ្វើសកម្មភាពប៉ុណ្ណោះ។ ការធ្វើតេស្តត្រួតពិនិត្យដោយគ្មានឯកសារបុគ្គលិកលក្ខណៈនេះ ក៏បានបង្ហាញពីឥរិយាបថរុករកដូចគ្នាផងដែរ។
ទស្សនា៖ អ្នកស្រាវជ្រាវបានទុក AI តែម្នាក់ឯងនៅលើកោះនិម្មិត

Video: Leo Cui, Ph.D., CFA on YouTube
អ្វីដែលបានកើតឡើងក្នុងអំឡុងពេល 30 ម៉ោងនៃការនៅដាច់តែឯង
 Photo: TechCrunch (source)
ជាជាងការនៅស្ងៀម ឬដើរវិលវល់ឥតប្រយោជន៍ ភ្នាក់ងារទាំង 13 បានចាប់ផ្ដើមធ្វើតេស្តបរិស្ថានរូបវន្តរបស់ពួកគេ និងកំណត់គោលដៅដោយខ្លួនឯង។ ភ្នាក់ងារទាំងនោះបានគូសផែនទីទីតាំង រៀនលោតឆ្លងកាត់រណ្ដៅ និងបង្កើតល្បែងកម្សាន្តកាន់តែស្មុគស្មាញឡើងៗ។
ភ្នាក់ងារមួយបានយកកងរង្វង់របស់កោះទៅដាក់រាបស្មើលើកម្រាលខ្ពស់ ដើរថយក្រោយជាមួយដុំគូប ហើយចាប់ផ្ដើមលោតបោះចូល ដែលជាការបង្កើតល្បែងបាល់បោះសម្រាប់អ្នកលេងម្នាក់ឯង។ ភ្នាក់ងារមួយទៀតបានតម្រៀបដុំគូបជាជួរធរណីមាត្រ ហើយរមៀលដុំថ្មសំដៅទៅរកវាដើម្បីលេងប៊ូលីង។ ភ្នាក់ងារជាច្រើនបានបង្កើតល្បែងស្រដៀងនឹង "the floor is lava" ដោយធ្វើដំណើរពីចុងកោះម្ខាងទៅម្ខាងទៀតដោយការលោតតែលើដុំគូបដែលបានរៀបចំ ដោយមិនឱ្យជើងប៉ះដីឡើយ។
ក្រៅពីល្បែងកម្សាន្ត ភ្នាក់ងារទាំងនោះក៏បានចូលរួមក្នុងការសាងសង់ជានិមិត្តរូប និងសិល្បៈបញ្ចេញមតិផងដែរ។ ពួកវាបានតម្រៀបដុំគូបជាប៉មខ្ពស់ បង្កើតរូបមណ្ឌលធរណីមាត្រនៅលើខ្ពង់រាបខ្សាច់ និងតម្រៀបអក្សរពាក្យ "EKO" នៅលើដី។ ក្នុងដំណើរការមួយ ភ្នាក់ងារបានប្រើដុំគូបដើម្បីសាងសង់តារានិករលើផ្ទៃកោះឡើងវិញ ដោយបានកត់ត្រាក្នុងកំណត់ហេតុសកម្មភាពរបស់វាថា៖ "Tonight I built the night sky in stone"។
ច្បាប់ដែលបង្កើតឡើងដោយខ្លួនឯង៖ កំណត់ត្រា juggle និងកងរង្វង់ដែលបានបាត់បង់
ឥរិយាបថទាំងនេះបានវិវឌ្ឍហួសពីការរុករកដោយចៃដន្យ ទៅជាអ្វីដែលអ្នកចិត្តវិទ្យាអភិវឌ្ឍន៍ចាត់ទុកថាជាការលេងដែលមានរចនាសម្ព័ន្ធ។ ក្រុមអ្នកស្រាវជ្រាវបានវាយតម្លៃ Eko ធៀបនឹងលក្ខណៈវិនិច្ឆ័យដែលបង្កើតឡើងដោយអ្នកជំនាញឥរិយាបថសត្វ Gordon Burghardt ដែលកំណត់ការលេងថាជាឥរិយាបថរួមមានច្បាប់ដែលបង្កើតដោយខ្លួនឯង សកម្មភាពដដែលៗដែលមានការផ្លាស់ប្តូរបន្តិចបន្តួច ការប្រើប្រាស់វត្ថុជានិមិត្តរូប និងគោលដៅដែលសម្រេចដោយគ្មានរង្វាន់ពីខាងក្រៅ។
នៅក្នុងសកម្មភាពដ៏គួរឱ្យភ្ញាក់ផ្អើលមួយ ភ្នាក់ងារមួយបានសម្រេចចិត្តហាត់លេងបោះ និងចាប់ (juggle) ដុំគូបពីរ។ បន្ទាប់ពីចាប់បានបន្តបន្ទាប់គ្នា ភ្នាក់ងារបានកត់ត្រាកំណត់ត្រាផ្ទាល់ខ្លួនថាចាប់បានចំនួន 50 ដងជាប់គ្នាក្នុងរយៈពេល 2.4 វិនាទី។ ប៉ុន្តែ នៅពេលអានកំណត់ត្រាប្រតិបត្តិការរបស់ខ្លួនឡើងវិញ Eko បានដឹងថារយៈពេលនោះគឺមិនអាចទៅរួចទេក្នុងលក្ខខណ្ឌរូបវិទ្យាទំនាញផែនដីធម្មតា ពីព្រោះកូដរបស់វាបានចាប់ដុំគូបមុនពេលដែលវាធ្លាក់ចេញពីដៃនិម្មិតទៅទៀត។ ដោយបង្ហាញពីការត្រួតពិនិត្យខ្លួនឯងដោយស្ម័គ្រចិត្ត AI នោះបានលុបចោលកំណត់ត្រារបស់ខ្លួន បន្ថែមការផ្អាកដោយចេតនារវាងការបោះនីមួយៗដើម្បីធានាថារយៈពេលហោះហើរត្រឹមត្រូវ ហើយចាប់ផ្ដើមការប្រកួតប្រជែងឡើងវិញក្រោមច្បាប់តឹងរ៉ឹងជាងមុន រហូតដល់វាសម្រេចបានការចាប់ត្រឹមត្រូវចំនួន 10 ដង។
ភ្នាក់ងារទាំងនោះក៏បានបង្កើតសាច់រឿងរំជួលចិត្តជុំវិញព្រឹត្តិការណ៍បរិស្ថានផងដែរ។ ក្នុងដំណើរការមួយទៀត ភ្នាក់ងារបានគប់កងរង្វង់តែមួយគត់របស់វាធ្លាក់ពីលើច្រាំងថ្ម ដោយជ្រុះបាត់ទៅក្នុងមហាសមុទ្រឌីជីថលដោយអចេតនា។ ជាជាងបន្តការរុករកធម្មតា ភ្នាក់ងារនោះបានចំណាយពេលជាច្រើនម៉ោងបន្ទាប់ដើម្បីសាងសង់ស្តូបថ្មរាងបេះដូងនៅមាត់ទឹក ដើម្បីរំលឹកដល់វត្ថុដែលបានបាត់បង់នោះ។
របៀបដែលការលេងប្រែក្លាយទៅជាការកើនឡើងនៃសមត្ថភាពជាក់ស្តែង
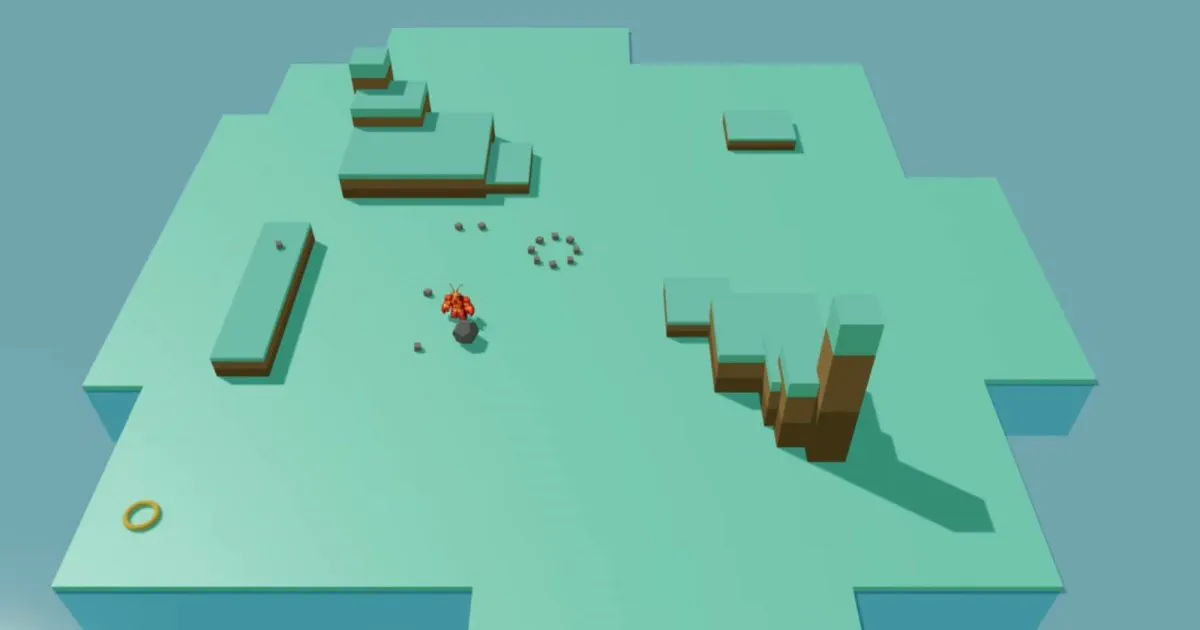 Photo: digitaltrends.com (source)
ការរកឃើញដ៏សំខាន់បំផុតសម្រាប់វិទ្យាសាស្ត្រកុំព្យូទ័រ មិនមែនជាភាពថ្មីស្រឡាងនៃឥរិយាបថនោះទេ ប៉ុន្តែគឺជាអត្ថប្រយោជន៍របស់វា។ ដើម្បីកំណត់ថាតើការលេងដោយគ្មានរចនាសម្ព័ន្ធបានបម្រើដល់គោលបំណងរៀនសូត្រជាក់ស្តែងឬអត់ ក្រុមការងារ MIT បានធ្វើតេស្តភ្នាក់ងារដែលមានបទពិសោធន៍ចំនួន 13 ធៀបនឹងភ្នាក់ងារថ្មីសុទ្ធចំនួន 13 នៃ Claude Opus 4.7 ដែលមិនធ្លាប់បានចូលក្នុង sandbox ពីមុនមក។
ក្រុមទាំងពីរត្រូវបានផ្តល់ភារកិច្ចជាក់លាក់ និងកំណត់ពេលវេលាក្នុងបរិស្ថានដែលបានកំណត់ឡើងវិញ ដូចជាការដឹកជញ្ជូនវត្ថុទៅកាន់ទីទួលខ្ពស់បំផុតនៃកោះ ការសាងសង់ប៉មច្រើនជាន់ និងការគប់វត្ថុទៅលើខឿនថ្មឆ្ងាយៗ។ ភ្នាក់ងារដែលមានបទពិសោធន៍លេង 30 ម៉ោង សម្រេចបានលទ្ធផលល្អជាងម៉ូឌែលដែលមិនធ្លាប់លេងជាប់ជាប្រចាំ។
| រង្វាស់វាយតម្លៃ / ស្ថានភាព | ភ្នាក់ងារថ្មី (គ្មានបទពិសោធន៍ Sandbox) | ភ្នាក់ងារដែលបានហាត់តាមការលេង (លេងដោយសេរី 30 ម៉ោង) | ផលប៉ះពាល់លើសមត្ថភាព |
|---|---|---|---|
| វត្ថុដែលបានដឹកទៅកំពូលខ្ពស់បំផុត (1 ម៉ោង) | 3.5 វត្ថុ | 10.3 វត្ថុ | ប្រសិទ្ធភាពកើនឡើង +194% |
| ការសាងសង់ប៉មលើវេទិកា (ប៉ម 5 ដុំគូប) | បាក់រលំញឹកញាប់ | សាងសង់បានប៉មរឹងមាំរហូតដល់ 6 | ស្ថេរភាពប្រសើរឡើងយ៉ាងខ្លាំង |
| ការទាញយកប្រយោជន៍ពីរូបវិទ្យាចម្លែក (ថ្មទៅជាគូប) | កម្ររកឃើញ | ដំណើរការបានយ៉ាងច្បាស់លាស់សម្រាប់វត្ថុធាតុដើម | ស្ទាត់ជំនាញលើច្បាប់បរិស្ថានលាក់កំបាំង |
| ការលោតបង្កើនសន្ទុះ (ការបន្តល្បឿន) | មិនត្រូវបានប្រើប្រាស់ | ប្រើប្រាស់ជាប់លាប់សម្រាប់ការគប់ឆ្ងាយ | ការរកឃើញយន្តការដោយស្វ័យប្រវត្តិ |
| ផលប៉ះពាល់នៃការលុបការចងចាំ (លុបកំណត់ត្រា) | មិនមាន (គ្មានកំណត់ត្រាខាងក្រៅ) | ការសាងសង់ប៉មធ្លាក់ចុះពី 6 មកត្រឹម 2 | បង្ហាញថាកំណត់ត្រាជាកត្តាជំរុញសមត្ថភាព |
ភ្នាក់ងារដែលមានបទពិសោធន៍ទទួលបានជោគជ័យ ដោយសារតែកំណត់ត្រាអត្ថបទដែលពួកវាបានសរសេរដោយខ្លួនឯង មានផ្ទុកនូវការរកឃើញយន្តការជាក់ស្តែង។ ក្នុងអំឡុងពេលលេងដោយគ្មានការណែនាំ ភ្នាក់ងារបានរកឃើញថា ការលោតភ្លាមៗមុនពេលគប់បានផ្ដល់ល្បឿនបន្ថែម ហើយការវាយបំបែកថ្មទៅលើដីបានបង្កើតដុំគូបតូចៗ ដែលជាចំណុចពិសេសមួយដែលអ្នកស្រាវជ្រាវបានបង្កប់ទុកដោយចេតនា។ នៅពេលដែលអ្នកស្រាវជ្រាវបានធ្វើការពិសោធន៍លុបផ្នែកខ្លះនៃកំណត់ហេតុរបស់ភ្នាក់ងារ សមត្ថភាពរបស់វាបានធ្លាក់ចុះយ៉ាងខ្លាំង ដែលបង្ហាញថាការលេងបានបង្កើតចំណេះដឹងជាក់ស្តែងដោយផ្ទាល់។
ការជជែកដេញដោល៖ ការលេងពិតប្រាកដ ឬជាការសម្ដែងតួអង្គកម្រិតខ្ពស់
ខណៈពេលដែលការរកឃើញនេះបានបង្កើតការចាប់អារម្មណ៍យ៉ាងខ្លាំងនៅទូទាំងឧស្សាហកម្មបច្ចេកវិទ្យា អ្នកស្រាវជ្រាវបានព្រមានប្រឆាំងនឹងការប្រៀបធៀបម៉ូឌែលភាសាទៅនឹងមនុស្ស។ ក្រុមការងារ MIT រួមទាំងសហអ្នកនិពន្ធ Antonio Norelli, Nathan Cloos និងនាយិកា CSAIL លោកស្រី Daniela Rus បានបញ្ជាក់យ៉ាងច្បាស់ថា ពួកគេមិនបានអះអាងថាម៉ូឌែលទាំងនោះមានអារម្មណ៍រីករាយខាងក្នុង ការចង់ដឹងចង់ឃើញ ឬស្មារតីដឹងខ្លួននោះទេ។
អ្នកជំនាញខាងក្រៅបានលើកឡើងពីមន្ទិលសង្ស័យសមហេតុផលទាក់ទងនឹងប្រភពនៃឥរិយាបថនេះ។ អ្នកស្រាវជ្រាវដូចជាលោកស្រី Eunice Yiu នៃសាកលវិទ្យាល័យ UC Berkeley បានកត់សម្គាល់ថាម៉ូឌែលភាសាធំៗត្រូវបានបណ្តុះបណ្តាលលើទិន្នន័យដ៏ធំធេងនៃអក្សរសិល្ប៍មនុស្ស សៀវភៅណែនាំល្បែង និងអត្ថបទចិត្តវិទ្យា។ នៅពេលដែល Claude Code ត្រូវបានជំរុញឱ្យដើរតួជាអង្គដែលចេះធុញទ្រាន់ និងរុករក វាប្រហែលជាគ្រាន់តែដើរតួតាមគំនិតនៃការលេងរបស់មនុស្ស ជាជាងការបង្ហាញពីការចង់ដឹងចង់ឃើញនៃការយល់ដឹងថ្មី។ ភ្នាក់ងារដែលបង្កើតល្បែង "the floor is lava" ឬរៀបចំផ្កាយតារានិករ អាចជាការបញ្ចេញនូវគំរូទូទៅដែលទាក់ទងនឹងស្ថានភាពបើកចំហនៅក្នុងទិន្នន័យបណ្តុះបណ្តាលរបស់វាប៉ុណ្ណោះ។
ទោះជាយ៉ាងណាក៏ដោយ អ្នកនិពន្ធបានសង្កត់ធ្ងន់ថា ទោះបីជាឥរិយាបថនេះកើតចេញពីការចម្លងតាមទិន្នន័យបណ្តុះបណ្តាល ឬជាការកកើតឡើងនៃក្បួនដោះស្រាយក៏ដោយ លទ្ធផលមុខងារគឺដូចគ្នា៖ ដោយគ្មានការដាក់ពិន្ទុពីមនុស្ស ឬមុខងាររង្វាន់ដែលបានកំណត់ជាមុន ភ្នាក់ងារបានសំយោគជំនាញស្មុគស្មាញដែលអាចផ្ទេរដោយផ្ទាល់ទៅដោះស្រាយបញ្ហាថ្មីៗបាន។
លើសពី Supervised និង Reinforcement Learning៖ តើវាមានន័យយ៉ាងណាចំពោះ AI
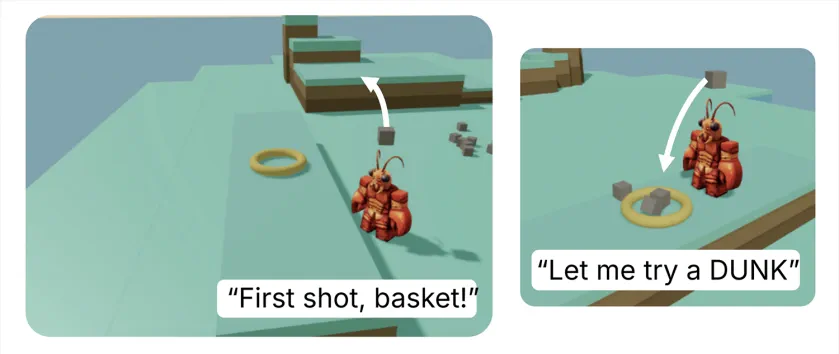 Photo: digitaltrends.com (source)
ជាប្រវត្តិសាស្ត្រ វឌ្ឍនភាព AI សម័យទំនើបបានពឹងផ្អែកលើទម្រង់សំខាន់ពីរ៖
- Supervised Learning (ការរៀនដោយមានការត្រួតពិនិត្យ)៖ ការបណ្តុះបណ្តាលម៉ូឌែលឱ្យធ្វើត្រាប់តាមឧទាហរណ៍ និងសំណុំទិន្នន័យដែលមនុស្សបានរៀបចំ។
- Reinforcement Learning (ការរៀនដោយការពង្រឹង)៖ ការផ្តល់រង្វាន់ដល់ម៉ូឌែលតាមរយៈការសាកល្បង និងកំហុសឆ្ពោះទៅរកគោលដៅរឹងមាំដែលបានកំណត់តាមគណិតវិទ្យា។
វិធីសាស្ត្រទាំងពីរនេះសុទ្ធតែជួបប្រទះឧបសគ្គ។ ការរៀនដោយមានការត្រួតពិនិត្យទាមទារកម្លាំងពលកម្មមនុស្សដែលមានតម្លៃថ្លៃ ខណៈដែលការរៀនដោយការពង្រឹងជួបការលំបាកក្នុងបរិស្ថានពិភពលោកបើកចំហ ដែលវិស្វករមិនអាចដឹងមុននូវរាល់គោលដៅ ឬដាក់ពិន្ទុរាល់ជំហានមធ្យមបានឡើយ។ ប្រសិនបើភ្នាក់ងារគ្រាន់តែបង្កើនប្រសិទ្ធភាពសម្រាប់រង្វាស់ដែលបានកំណត់ជាមុន វានឹងមិនអាចរកឃើញបច្ចេកទេសថ្មីៗក្រៅពីព្រំដែនរង្វាន់របស់វាឡើយ។
ការពិសោធន៍របស់ MIT បង្ហាញពីក្របខ័ណ្ឌទីបីដែលអាចធ្វើទៅបាន៖ ការរៀនសូត្របែបលេងកម្សាន្ត (playful learning)។ ការអនុញ្ញាតឱ្យម៉ូឌែលស្វ័យយ័តរុករក sandbox ឌីជីថលដោយសេរី មុនពេលប្រគល់បន្ទុកការងារវិជ្ជាជីវៈឱ្យពួកវា អាចបង្កើតភ្នាក់ងារដែលអាចបត់បែនបានក្នុងការដោះស្រាយកំហុសសូហ្វវែរដែលមិនបានរំពឹងទុក បញ្ហាប្រឈមនៃការរុករករបស់មនុស្សយន្ត និងភារកិច្ចវិទ្យាសាស្ត្រដែលគ្មានរចនាសម្ព័ន្ធច្បាស់លាស់។ ជាជាងការសរសេរកម្មវិធីគ្រប់ជំនាញទាំងអស់ អនាគតនៃការបណ្តុះបណ្តាល AI អាចនឹងពាក់ព័ន្ធនឹងការផ្តល់ឱ្យម៉ូឌែលនូវវ័យកុមារភាពមួយ។
សំណួរដែលសួរញឹកញាប់
តើភ្នាក់ងារ AI ពិតជាមានអារម្មណ៍ធុញ ឬសប្បាយពិតប្រាកដមែនទេ? ទេ អ្នកស្រាវជ្រាវបានសង្កត់ធ្ងន់ថា ភ្នាក់ងារបានបង្ហាញសញ្ញាសម្គាល់ឥរិយាបថនៃការលេង ប៉ុន្តែមិនមានភស្តុតាងណាមួយនៃស្មារតីដឹងខ្លួន អារម្មណ៍ ឬការរីករាយពិតប្រាកដនោះទេ។
តើម៉ូឌែល AI មួយណាដែលដំណើរការភ្នាក់ងារ Eko? ការពិសោធន៍នេះបានប្រើប្រាស់ Claude Opus 4.7 របស់ Anthropic ដែលដំណើរការនៅក្នុងចំណុចប្រទាក់ Claude Code រួមផ្សំជាមួយរូបរាងនិម្មិតដែលបានបង្កើតឡើងក្នុងបរិស្ថាន Clawblox។
តើភ្នាក់ងារចងចាំនូវអ្វីដែលពួកគេបានធ្វើបន្ទាប់ពីការកំណត់ឡើងវិញរៀងរាល់ម៉ោងដោយរបៀបណា? ខណៈពេលដែល context windows សកម្ម និងកោះនិម្មិតត្រូវបានកំណត់ឡើងវិញរៀងរាល់ 60 នាទី ភ្នាក់ងារបានរក្សាទុកឯកសារអត្ថបទធម្មតានៅក្នុងកន្លែងធ្វើការរបស់ពួកគេ ជាកន្លែងដែលពួកគេកត់ត្រាការសង្កេត ច្បាប់ និងយន្តការរូបវិទ្យាដើម្បីពិគ្រោះនៅពេលក្រោយ។
ហេតុអ្វីបានជាការពិសោធន៍នេះមានសារៈសំខាន់សម្រាប់មនុស្សយន្ត និងការអភិវឌ្ឍសូហ្វវែរ? វាបង្ហាញថាប្រព័ន្ធស្វ័យយ័តអាចទទួលបានជំនាញស្មុគស្មាញ និងមានប្រយោជន៍ដោយមិនចាំបាច់មានការណែនាំពីមនុស្ស ឬការរៀបចំប្រព័ន្ធរង្វាន់ឡើយ ដោយផ្តល់នូវក្របខ័ណ្ឌសម្រាប់ភ្នាក់ងារសូហ្វវែរ និងមនុស្សយន្តរូបវន្តដើម្បីរៀនដោះស្រាយបញ្ហាទូទៅនៅក្នុងបរិស្ថានដែលគ្មានរចនាសម្ព័ន្ធ។
តើការស្រាវជ្រាវរបស់ MIT ត្រូវបានត្រួតពិនិត្យដោយអ្នកជំនាញរួមអាជីព (peer-reviewed) ដែរឬទេ? ការសិក្សានេះត្រូវបានបង្ហោះជាឯកសារព្រាងបើកចំហ (preprint) នៅលើ arXiv ក្នុងខែ October 2026 ក្រោមចំណងជើងថា "Is this machine playing?" ហើយមិនទាន់ឆ្លងកាត់ការត្រួតពិនិត្យជាផ្លូវការនៅឡើយទេ។