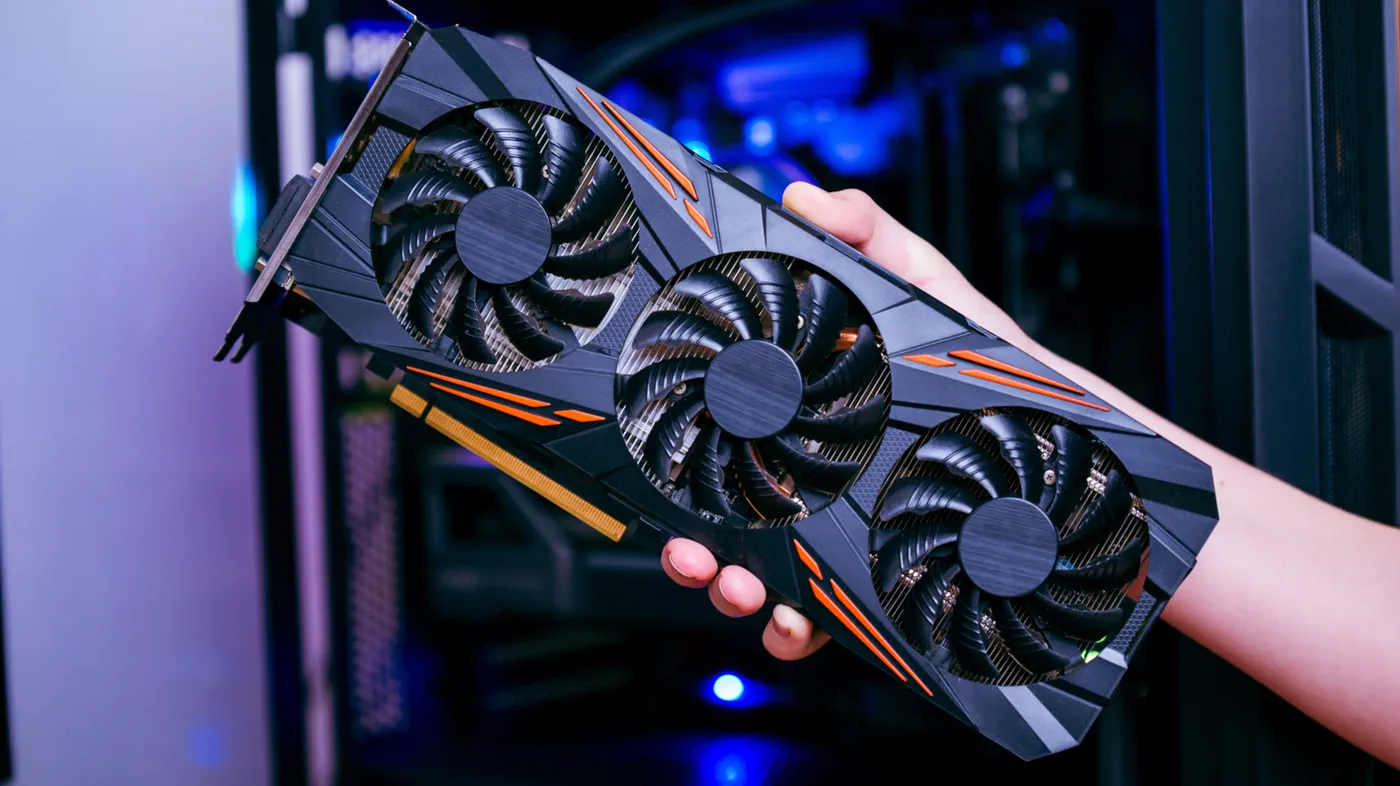
ការដំណើរការម៉ូឌែលបញ្ញាសិប្បនិម្មិត (AI) ដោយផ្ទាល់នៅលើកុំព្យូទ័រផ្ទាល់ខ្លួនរបស់អ្នក បានវិវត្តយ៉ាងឆាប់រហ័សពីការពិសោធន៍ដ៏ស្មុគស្មាញរបស់អ្នកអភិវឌ្ឍន៍ ទៅជាឧបករណ៍ប្រចាំថ្ងៃដែលអាចប្រើប្រាស់បានយ៉ាងទូលំទូលាយ។ តាមរយៈកម្មវិធីឥតគិតថ្លៃ និងមានភាពងាយស្រួលដូចជា Ollama និង LM Studio នរណាក៏អាចទាញយកម៉ូឌែល open-weight ផ្តាច់ការតភ្ជាប់អ៊ីនធឺណិត ហើយសន្ទនាជាមួយ AI chatbot បានដោយមិនចាំបាច់បង់ថ្លៃសេវាប្រចាំខែ ឬផ្ញើទិន្នន័យផ្ទាល់ខ្លួនទៅកាន់ remote cloud server ឡើយ។ ទោះជាយ៉ាងណាក៏ដោយ ការដែលកុំព្យូទ័ររបស់អ្នកអាចឆ្លើយតបបានលឿនដូចផ្លេកបន្ទោរ ឬគាំងរហូតដល់លែងដំណើរការ គឺអាស្រ័យលើ hardware ដែលមាននៅក្នុងម៉ាស៊ីន desktop ឬ laptop របស់អ្នក។
ខណៈពេលដែលម៉ាស៊ីនកម្រិតមធ្យមអាចគ្រប់គ្រងកិច្ចការសន្ទនាស្រាលៗបាន ការឈានទៅដល់កម្រិតសមត្ថភាពវែកញែកដូចឧបករណ៍ពាណិជ្ជកម្មល្បីៗ ដូចជា ChatGPT ឬ Claude ទាមទារឱ្យមានរចនាសម្ព័ន្ធប្រព័ន្ធជាក់លាក់។ ដើម្បីយល់ដឹងពីអ្វីដែលកុំព្យូទ័ររបស់អ្នកអាចដំណើរការបានជាក់ស្តែង និងថាតើការដំឡើងគ្រឿងបន្ថែមត្រូវចំណាយប្រាក់ប៉ុន្មាន អ្នកត្រូវមើលរំលងលើសពីលទ្ធផលតេស្តហ្គេមធម្មតា ហើយផ្តោតសំខាន់លើអង្គចងចាំ (memory), កម្រិតបញ្ជូនទិន្នន័យ (bandwidth), និងសមត្ថភាពគណនា (compute)។
រង្វាស់សម្រេច៖ ហេតុអ្វីបានជា VRAM និងទំហំអង្គចងចាំជាអ្នកកំណត់
នៅពេលទិញ ឬរៀបចំដំឡើងកុំព្យូទ័រសម្រាប់កិច្ចការទូទៅ អ្នកទិញច្រើនតែផ្តោតលើល្បឿន clock speed របស់អង្គប្រតិបត្តិការកណ្តាល (CPU) ឬកម្រិត frame rate នៃការលេងហ្គេម។ ប៉ុន្តែសម្រាប់ម៉ូឌែលភាសាធំៗ (LLMs) លើម៉ាស៊ីនផ្ទាល់ ឧបសគ្គ hardware ដ៏សំខាន់បំផុតគឺទំហំអង្គចងចាំសុទ្ធសាធ។
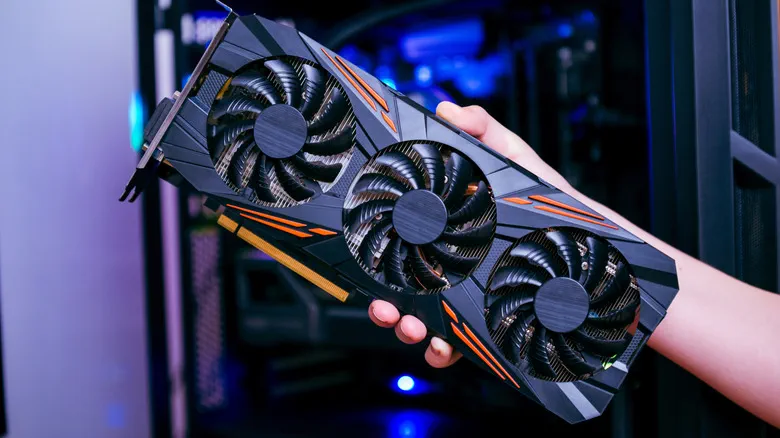
មុនពេលម៉ូឌែល AI អាចបង្កើតពាក្យបានសូម្បីតែមួយម៉ាត់ បណ្តាញប្រសាទគណិតវិទ្យាទាំងមូលរបស់វា ដែលគេស្គាល់ថាជា weights ត្រូវតែផ្ទុកចូលទៅក្នុងអង្គចងចាំសកម្ម និងមានល្បឿនលឿន។ ប្រសិនបើម៉ូឌែលនោះមិនអាចផ្ទុកក្នុងអង្គចងចាំអស់ទេ វានឹងមិនដំណើរការឡើយ។ នៅលើកុំព្យូទ័រ desktop ដំណើរការដោយ Windows ឬ Linux កម្រិតស្តង់ដារមាសគឺ Video RAM (VRAM) ដែលភ្ជាប់ផ្ទាល់នៅលើបន្ទះក្រាហ្វិកកាតដាច់ (GPU)។
ប្រសិនបើ GPU របស់អ្នកអស់ VRAM កម្មវិធីជំនួយអាចបញ្ជូន (offload) ស្រទាប់ដែលនៅសល់ទៅកាន់ DDR4 ឬ DDR5 RAM ធម្មតារបស់ប្រព័ន្ធ។ ទោះបីជាវិធីនេះអាចការពារកុំព្យូទ័រកុំឱ្យគាំងមែន ប៉ុន្តែការ offload បង្កឱ្យមានការធ្លាក់ចុះល្បឿនយ៉ាងខ្លាំង។ System RAM ផ្ទេរទិន្នន័យក្នុងល្បឿនយឺតជាងអង្គចងចាំក្រាហ្វិកច្រើនដង ដែលធ្វើឱ្យល្បឿនបង្កើតអក្សរធ្លាក់ចុះពីកម្រិតរលូន 40 tokens ក្នុងមួយវិនាទី មកនៅត្រឹមមួយ ឬពីរពាក្យប៉ុណ្ណោះក្នុងមួយវិនាទី ដែលយឺតខ្លាំងមិនអាចទទួលយកបាន។
ទស្សនា៖ ការពន្យល់ពី Local AI៖ របៀបដំណើរការម៉ូឌែល AI នៅលើកុំព្យូទ័ររបស់អ្នក

វីដេអូ: Tech With Tim on YouTube
ស្វែងយល់ពីទំហំម៉ូឌែល និងអត្ថប្រយោជន៍នៃ Quantization
 រូបថត: Engadget - Technology News & Expert Reviews (source)
ម៉ូឌែល AI លើម៉ាស៊ីនផ្ទាល់ត្រូវបានបែងចែកតាមចំនួន parameter ដែលគិតជាពាន់លាន (តំណាងដោយអក្សរ "B")។ Parameters គឺជាចំណងតភ្ជាប់គណិតវិទ្យាដែលបានរៀននៅក្នុងម៉ូឌែល៖ ម៉ូឌែលដែលមាន 8 ពាន់លាន parameters (8B) ផ្ទុកចំណេះដឹងទូទៅតិចជាងម៉ូឌែលដែលមាន 70 ពាន់លាន parameters (70B) ប៉ុន្តែវាទាមទារទំហំផ្ទុកតិចជាងឆ្ងាយណាស់។
នៅកម្រិតភាពច្បាស់ពេញលេញ 16-bit precision (FP16) រាល់ parameter នីមួយៗទាមទារទំហំផ្ទុក 2 bytes។ ម៉ូឌែល 8B ដែលមិនទាន់បង្រួម ទាមទារ VRAM ប្រមាណ 16GB គ្រាន់តែដើម្បីដំណើរការ ខណៈដែលម៉ូឌែល 70B ត្រូវការរហូតដល់ 140GB។ ដើម្បីឱ្យម៉ូឌែលទាំងនេះដំណើរការបានលើ hardware កម្រិតអ្នកប្រើប្រាស់ទូទៅ អ្នកអភិវឌ្ឍន៍ប្រើប្រាស់បច្ចេកទេស quantization ដែលជាវិធីសាស្ត្របង្ហាប់គណិតវិទ្យាដើម្បីបង្រួម parameter នីមួយៗមកនៅត្រឹម 4 bits (Q4) ដោយស្ទើរតែមិនប៉ះពាល់ដល់ភាពត្រឹមត្រូវនៃការសន្ទនាទូទៅឡើយ។
ក្នុងទម្រង់ស្តង់ដារ 4-bit (ដូចជាឯកសារ Q4_K_M ដែលកំណត់ជាលំនាំដើមក្នុង Ollama និង LM Studio) ទំហំម៉ូឌែលថយចុះមកនៅត្រឹមប្រមាណមួយភាគបួននៃទំហំដើមប៉ុណ្ណោះ៖
- ម៉ូឌែលខ្នាតតូច (3B–4B): ត្រូវការអង្គចងចាំប្រហែល 2GB ទៅ 3GB (ឧទាហរណ៍៖ Llama 3.2 3B, Phi-3 Mini)។
- ម៉ូឌែលទូទៅពេញនិយម (7B–8B): ត្រូវការអង្គចងចាំប្រហែល 5GB ទៅ 6GB (ឧទាហរណ៍៖ Llama 3.1 8B, Qwen3 8B)។
- ម៉ូឌែលកម្រិតមធ្យម (14B): ត្រូវការអង្គចងចាំប្រហែល 9GB ទៅ 10GB (ឧទាហរណ៍៖ Microsoft Phi-4, Qwen 2.5 14B)។
- ម៉ូឌែលខ្នាតធំ (27B–32B): ត្រូវការអង្គចងចាំប្រហែល 18GB ទៅ 22GB (ឧទាហរណ៍៖ Gemma 3 27B, Qwen 2.5 32B)។
- ម៉ូឌែលកំពូល (70B): ត្រូវការអង្គចងចាំប្រហែល 42GB ទៅ 48GB (ឧទាហរណ៍៖ Llama 3.3 70B)។
អ្នកប្រើប្រាស់ក៏ត្រូវត្រៀមអង្គចងចាំបន្ថែមពី 1GB ទៅ 3GB ទៀតសម្រាប់ context window (KV cache) ដែលជាកន្លែងរក្សាប្រវត្តិនៃការសន្ទនាវែងៗ និងឯកសារដែលបានបញ្ចូល។
កម្រិត Hardware៖ តើកុំព្យូទ័ររបស់អ្នកអាចដំណើរការអ្វីបានខ្លះ
ដោយសារតម្រូវការអង្គចងចាំរបស់ម៉ូឌែលកើនឡើងតាមលំដាប់ជាក់លាក់ ការកំណត់រចនាសម្ព័ន្ធកុំព្យូទ័រត្រូវបានចែកចេញជាកម្រិតសមត្ថភាពដាច់ដោយឡែកពីគ្នា៖
| កម្រិត Hardware | លក្ខណៈសម្បត្តិទូទៅ | ទំហំម៉ូឌែលដែលអាចដំណើរការបាន (4-bit) | ឧទាហរណ៍ជាក់ស្តែង | បទពិសោធន៍រំពឹងទុក |
|---|---|---|---|---|
| កម្រិតដំបូង (CPU သុទ្ធ) | CPU ជំនាន់ថ្មី, 16GB System RAM, Integrated Graphics | 3B ដល់ 8B (ទម្រង់ CPU) | Llama 3.2 3B, Gemma 2 2B | អាចប្រើសម្រាប់សរសេរអត្ថបទ និងសង្ខេបខ្លឹមសារ; ល្បឿនចន្លោះពី 6–12 tokens/វិនាទី។ |
| កម្រិត GPU សន្សំសំចៃ | 8GB–12GB VRAM (Nvidia RTX 3060 12GB / RTX 4060) | 7B ដល់ 8B, និង 14B កម្រិតទាប | Llama 3.1 8B, Mistral 7B, Qwen3 8B | ឆ្លើយតបភ្លាមៗ (30–60 tokens/វិនាទី); គ្រប់គ្រងការសរសេរកូដ សន្ទនាប្រចាំថ្ងៃ និងឆ្លើយសំណួរពីឯកសារ។ |
| កម្រិតមធ្យមសម្រាប់ធ្វើការ | 16GB VRAM (RTX 4060 Ti 16GB / RTX 4070 Ti Super) | រហូតដល់ 14B–20B MoE | Phi-4 14B, gpt-oss-20b | មានទំហំសល់ស្រួលសម្រាប់ context windows ធំ និងកិច្ចការ agent ច្រើនដំណាក់កាល។ |
| កម្រិតអ្នកជំនាញ | 24GB VRAM (RTX 3090, RTX 4090) | 27B ដល់ 32B | Gemma 3 27B, Qwen 2.5 32B | សមត្ថភាពវែកញែកខ្ពស់ ជំនួយការសរសេរកូដល្អឥតខ្ចោះ និងមានភាពត្រឹមត្រូវជិតដល់ម៉ូឌែលកំពូល។ |
| កម្រិតអាជីព / Dual-GPU | 48GB+ VRAM ឬ Unified Memory (2x RTX 3090/4090, Mac Studio) | 70B | Llama 3.3 70B, DeepSeek 70B | AI លើម៉ាស៊ីនផ្ទាល់កម្រិតកំពូលពិតប្រាកដ; អាចដោះស្រាយការវិភាគតក្កវិជ្ជាស្មុគស្មាញ កូដធំៗ និងការវិភាគស៊ីជម្រៅ។ |
កម្រិតបញ្ជូនទិន្នន័យ (Memory Bandwidth), GPU, និងមូលហេតុដែល CPU និង NPU ដើរយឺតជាង
 រូបថត: Engadget - Technology News & Expert Reviews (source)
ខណៈពេលដែលទំហំអង្គចងចាំជាអ្នកកំណត់ថា តើ ម៉ូឌែល AI អាចដាក់ចូលអស់ឬអត់នោះ កម្រិតបញ្ជូនទិន្នន័យ (memory bandwidth) គឺជាអ្នកកំណត់ថា តើ វាអាចបង្កើតអត្ថបទបានលឿនប៉ុណ្ណា។ ក្នុងអំឡុងពេលបង្កើត token ម៉ូឌែល LLM ត្រូវអាន parameters រាប់ពាន់លានសម្រាប់រាល់ពាក្យនីមួយៗដែលវាបញ្ចេញ។
កុំព្យូទ័រ desktop ទូទៅដែលប្រើប្រាស់ dual-channel DDR5 system RAM ផ្តល់ bandwidth ប្រហែល 60GB/s ទៅ 80GB/s ប៉ុណ្ណោះ។ ចំណែកឯក្រាហ្វិកកាតកម្រិតមធ្យមដែលប្រើអង្គចងចាំ GDDR6 អាចបញ្ជូនបានលើសពី 300GB/s យ៉ាងងាយស្រួល ហើយកាតកម្រិតខ្ពស់ដូចជា RTX 4090 អាចលើសពី 1,000GB/s។ ដោយសារ GPU អាចបញ្ជូន parameters ទៅកាន់ compute cores របស់វាបានលឿនជាង motherboard បញ្ជូនទៅ CPU ពីដប់ទៅដប់ប្រាំដង ការបង្កើត token លើ GPU ផ្តល់នូវអារម្មណ៍ឆ្លើយតបភ្លាមៗ និងរលូនល្អ។
ចុះចំណែកបន្ទះ Neural Processing Units (NPU) ដែលបំពាក់លើឈីប Copilot+ PC ជំនាន់ថ្មីពី Intel, AMD, និង Qualcomm វិញ? ទោះបីជាមានការផ្សព្វផ្សាយយ៉ាងខ្លាំងអំពី AI ក៏ដោយ ក៏ NPU សម្រាប់អ្នកប្រើប្រាស់ទូទៅមានកម្លាំងត្រឹមតែប្រហែល 40 ទៅ 50 TOPS (ទ្រីលានប្រមាណវិធីក្នុងមួយវិនាទី) ប៉ុណ្ណោះ ហើយត្រូវបានបង្កើតឡើងសម្រាប់កិច្ចការស្រាលៗនៅផ្ទៃខាងក្រោយដែលសន្សំសំចៃថាមពល ដូចជាការធ្វើឱ្យព្រាលផ្ទៃខាងក្រោយកាមេរ៉ា ការបម្លែងសំឡេងផ្ទាល់ទៅជាអត្ថបទ និងការកែសម្រួលរូបភាព។ ពួកវាត្រូវចែករំលែក System RAM ធម្មតា និងខ្វះ memory bandwidth ដែលចាំបាច់សម្រាប់ដំណើរការម៉ូឌែលអត្ថបទខ្នាតធំក្នុងល្បឿនលឿន។
ជម្រើស Mac៖ គុណសម្បត្តិ Unified Memory របស់ Apple Silicon
នៅលើកុំព្យូទ័រ desktop ប្រព័ន្ធ Windows អ្នកប្រើប្រាស់ជួបប្រទះនឹងកម្រិតកំណត់ hardware ដ៏តឹងរ៉ឹង៖ ក្រាហ្វិកកាតទូទៅសម្រាប់អ្នកប្រើប្រាស់មាន VRAM អតិបរមាត្រឹមតែ 24GB ប៉ុណ្ណោះ។ ការឈានទៅប្រើ GPU កម្រិតសហគ្រាសដូចជា Nvidia RTX 6000 Ada ដែលមាន 48GB ត្រូវចំណាយរហូតដល់ជាង $6,000។
Apple Silicon (ប្រព័ន្ធដំណើរការត្រកូល M-series ក្នុង MacBook Pro, Mac mini, និង Mac Studio) ប្រើប្រាស់ស្ថាបត្យកម្ម Unified Memory ដែល CPU និង GPU ចែករំលែកអង្គចងចាំល្បឿនលឿនជាមួយគ្នា។ ម៉ាស៊ីន Mac Studio ឬ MacBook Pro កម្រិតខ្ពស់ដែលបំពាក់ Unified Memory ទំហំ 64GB, 96GB, ឬ 128GB អាចបែងចែករហូតដល់ 75% ឬច្រើនជាងនេះទៅឱ្យ GPU ប្រើប្រាស់ដោយផ្ទាល់។
ទោះបីជាល្បឿនបង្កើត token លើឈីប Apple យឺតជាង GPU ដាច់របស់ Nvidia នៅលើ desktop បន្តិចបន្តួច ដោយសារមានចំនួន tensor computing cores តិចជាងក៏ដោយ ក៏ម៉ាស៊ីន Apple Silicon អាចផ្ទុកម៉ូឌែល 70B ទាំងមូលនៅក្នុង Unified Memory ដោយចំណាយថវិកាតិចជាងការដំឡើងកុំព្យូទ័រ PC ដែលប្រើ GPU ច្រើនគ្រាប់រាប់ពាន់ដុល្លារ។
ការចំណាយ៖ ការដំឡើងគ្រឿងបន្ថែម ឬការរៀបចំម៉ាស៊ីនថ្មីទាំងស្រុង
 រូបថត: llmconfigurator.com (source)
ការចាប់ផ្តើមប្រើប្រាស់ local AI មិនតម្រូវឱ្យអ្នកចំណាយលុយទិញសម្ភារភ្លាមៗនោះទេ៖
- ជម្រើសមិនអស់ប្រាក់សោះ ($0): ប្រសិនបើអ្នកមានកុំព្យូទ័រ desktop ឬ laptop ដែលផលិតក្នុងរយៈពេល 4 ឆ្នាំចុងក្រោយនេះ និងមាន RAM យ៉ាងតិច 16GB អ្នកអាចសាកល្បងដំណើរការម៉ូឌែល quantized 3B និង 7B លើ CPU mode បានភ្លាមៗដោយឥតគិតថ្លៃ។
- ការដំឡើងថវិកាសន្សំសំចៃ $300 ទៅ $500: សម្រាប់អ្នកមាន desktop ដែលមានរន្ធ PCIe សល់ និង power supply ល្អ ការទិញ Nvidia GeForce RTX 3060 12GB មួយទឹក (ជាញឹកញាប់ក្រោម $250) ឬ RTX 4060 Ti 16GB ថ្មី (តម្លៃប្រហែល $450) នឹងជួយបង្កើនសមត្ថភាពគួរឱ្យកត់សម្គាល់ ដោយអាចដំណើរការម៉ូឌែល 8B ដល់ 14B ក្នុងល្បឿន GPU ពេញលេញ។
- ជម្រើសដែលល្អបំផុតក្នុងកម្រិត $700 ទៅ $900: នៅក្នុងសហគមន៍ AI លើម៉ាស៊ីនផ្ទាល់ កាតមួយទឹក Nvidia GeForce RTX 3090 24GB ត្រូវបានចាត់ទុកជាជម្រើសដែលមានតម្លៃសមរម្យ និងល្អបំផុត។ វាផ្តល់ទំហំ 24GB ស្មើនឹង RTX 4090 ដែលមានតម្លៃលើសពី $1,800 ដែលអនុញ្ញាតឱ្យអ្នកដំណើរការម៉ូឌែល 32B បានយ៉ាងរលូនដោយគ្មានបញ្ហា។
GPU របស់ Nvidia នៅតែជាជម្រើសដែលគេណែនាំជាងគេ បើប្រៀបធៀបជាមួយ AMD ឬ Intel សម្រាប់ការប្រើប្រាស់ AI ផ្ទាល់លើម៉ាស៊ីន ដោយសារប្រព័ន្ធអេកូឡូស៊ីកម្មវិធី CUDA របស់ Nvidia ទទួលបានការគាំទ្រស្ទើរតែទាំងស្រុង និងងាយស្រួលដំឡើងនៅក្នុងឧបករណ៍ AI បែប open-source។
ដំបូន្មានជាក់ស្តែងសម្រាប់អ្នកទិញ៖ របៀបចាប់ផ្តើមនៅថ្ងៃនេះ
មុននឹងចំណាយប្រាក់ទិញគ្រឿងបន្លាស់ថ្មី សូមដំឡើង Ollama ឬ LM Studio លើកុំព្យូទ័រដែលមានស្រាប់របស់អ្នក។ សាកល្បងទាញយកម៉ូឌែលស្រាលៗដូចជា Llama 3.2 3B ឬ Mistral 7B ដើម្បីវាយតម្លៃសមត្ថភាពម៉ាស៊ីនរបស់អ្នក។
ប្រសិនបើអ្នកយល់ថាចម្លើយឆ្លើយតបមានប្រយោជន៍សម្រាប់ការសរសេរព្រាងអ៊ីមែល ស្វែងរកកំហុសកូដ (debugging) ឬវិភាគឯកសារផ្ទាល់ខ្លួន សូមពិនិត្យមើល task manager អំឡុងពេលដំណើរការ។ ប្រសិនបើ VRAM របស់ GPU ពេញ ហើយល្បឿនឆ្លើយតបយឺតយ៉ាវ សូមផ្តោតការទិញ hardware បន្ទាប់របស់អ្នកទៅលើ ទំហំ VRAM ជាចម្បង, memory bandwidth ជាលំដាប់បន្ទាប់, និងទុក clock speeds នៅចុងក្រោយគេ។
សំណួរដែលសួរញឹកញាប់
តើខ្ញុំអាចដំណើរការ AI លើ PC ដែលគ្មានក្រាហ្វិកកាតដាច់បានដែរឬទេ? បាន កម្មវិធីដូចជា Ollama និង LM Studio អាចដំណើរការម៉ូឌែលទាំងស្រុងលើ CPU ដោយប្រើប្រាស់ System RAM។ ទោះបីជា PC ដែលមាន 16GB អាចដំណើរការម៉ូឌែល 7B ឬ 8B បានក៏ដោយ ប៉ុន្តែល្បឿននៃការឆ្លើយតបនឹងយឺតជាងមុនគួរឱ្យកត់សម្គាល់ (ប្រហែល 6 ដល់ 12 ពាក្យក្នុងមួយវិនាទី) បើធៀបនឹងការដំណើរការលើ GPU ដាច់។
ហេតុអ្វីបានជា Nvidia ត្រូវបានណែនាំជាង AMD សម្រាប់ AI លើម៉ាស៊ីនផ្ទាល់? បណ្ណាល័យ AI បែប open-source ភាគច្រើនត្រូវបានចងក្រងឡើងជាពិសេសសម្រាប់ស្ថាបត្យកម្ម CUDA របស់ Nvidia ដែលផ្តល់នូវការបង្កើនល្បឿន hardware ដោយស្វ័យប្រវត្តិ និងងាយស្រួលដំឡើងបំផុត។ ទោះបីជាកាត AMD អាចដំណើរការបានតាមរយៈ ROCm ឬ Vulkan ក៏ដោយ ក៏ភាពត្រូវគ្នានៃកម្មវិធី និងការដំឡើង driver ទាមទារជំនាញបច្ចេកទេសដោះស្រាយបញ្ហាច្រើន។
តើម៉ូឌែល AI ស៊ីទំហំផ្ទុក storage ប៉ុន្មានដែរ? ម៉ូឌែលដែលបានបង្រួមទម្រង់ 4-bit មានទំហំចាប់ពីប្រហែល 2GB សម្រាប់ម៉ូឌែល 3B ដល់ 5GB សម្រាប់ម៉ូឌែល 8B, 10GB សម្រាប់ម៉ូឌែល 14B និងលើសពី 40GB សម្រាប់ម៉ូឌែល 70B។ ដោយសារការផ្ទុកទិន្នន័យបានលឿនអាស្រ័យលើល្បឿនអានទិន្នន័យ ការរក្សាទុកម៉ូឌែលនៅលើ NVMe SSD គឺជាជម្រើសដ៏ល្អបំផុត។
តើ NPU លើ Copilot+ PC អាចជំនួស GPU ដាច់សម្រាប់ម៉ូឌែល LLMs បានដែរឬទេ? មិនអាចទេ បច្ចុប្បន្ន NPU សម្រាប់អ្នកប្រើប្រាស់ទូទៅនៅខ្វះ memory bandwidth និងសមត្ថភាពគណនាដែលចាំបាច់សម្រាប់ទ្រទ្រង់ម៉ូឌែលភាសាធំៗ ឬមធ្យមឱ្យឆ្លើយតបបានរហ័ស។ ពួកវាត្រូវបានរចនាឡើងជាចម្បងសម្រាប់មុខងារកិច្ចការស្រាលៗនៅផ្ទៃខាងក្រោយដែលស៊ីភ្លើងតិច មិនមែនសម្រាប់ការបង្កើតអត្ថបទធ្ងន់ធ្ងរនោះឡើយ។