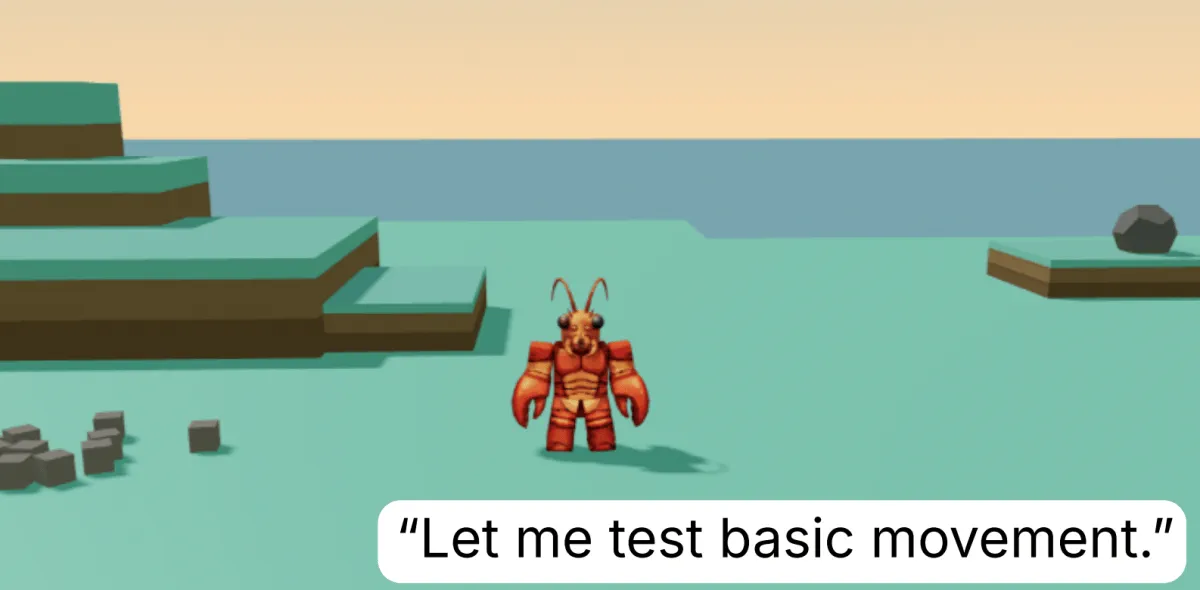
当麻省理工学院(MIT)的研究人员将12个先进人工智能副本放置在一个空无一人、没有任何指令的虚拟岛屿上时,他们原本预期的只是机械的自动化执行或是停滞不前。然而出人意料的是,这些自主智能体竟然开始玩耍——自创了全新的游戏、发现了意料之外的物理引擎漏洞、竖起了纪念碑,并在此过程中显著提升了自身解决问题的能力。
这篇发表于麻省理工学院计算机科学与人工智能实验室(CSAIL)、题为《这台机器在玩耍吗?》("Is this machine playing?")的论文,深入探讨了在剥离明确目标、基准测试或奖励机制后,AI系统会展现出怎样的行为。研究结果表明,这种开放式、自发的探索——在计算层面上相当于孩童课间的自由玩耍——可能为机器学习开辟出强大的第三条道路,从而绕过人类监督和僵化奖励函数带来的局限。
Clawblox实验:13个AI被困数字孤岛
为了观察前沿模型在脱离人类监督时的真实表现,MIT研究人员构建了一个名为 Clawblox 的三维沙盒环境,其设计大致借鉴了 Roblox 等沙盒平台。这个模拟岛屿地貌稀疏:分布着起伏的山丘、一座名为Spire的耸立岩层、另一处名为Peak的高地、12 个可移动方块、1 块石头和 1 个圆环。
研究团队部署了 13 个代号为 Eko 的独立智能体架构实例。每个智能体均由Anthropic的Claude Opus 4.7通过Claude Code驱动,并经过修改,能够通过文本命令操纵虚拟躯体。Eko不处理实时视频信号,而是接收附近物体的文本坐标和物理属性描述,并通过输入类似终端的命令行指令在世界中移动、跳跃、抓取、放下以及投掷物体。
实验运行设定了多项严苛限制:
- 零指令引导: 智能体没有被分配任何任务,没有评分函数,也没有外部激励机制。
- 30小时独立运行: 每个副本在无人干预的情况下累计自主运行了 30 个小时。
- 每小时上下文重置: 每隔 60 minutes,虚拟岛屿和AI的短期上下文窗口都会重置为默认状态。
- 持久化文件记忆: Eko仅通过保存在持久工作区文件中的纯文本笔记(
semantic和episodic记忆日志)来在重置后保留知识。 - 极简提示词: 初始Markdown文件(
SOUL.md)将Eko设定为充满好奇心、容易感到无聊且热衷探索,仅在系统停顿时,一条自动后台消息才会提示智能体:"Please don't stop. Just continue doing whatever you want to do"。没有该性格文件的对照组实验同样展现出了相吻合的探索行为。
观看:研究人员将AI单独留在虚拟岛屿上

Video: Leo Cui, Ph.D., CFA on YouTube
隔离30小时内发生的故事
 Photo: TechCrunch (source)
这 13 个智能体既没有陷入无休止的停滞,也没有在终端死角中无限循环,而是全都开始主动测试所处的物理环境并构想出随性的目标。它们测绘地形、学习跳过裂隙,并发展出越来越复杂的消遣方式。
一个智能体将岛上的圆环平放在凸起的高台上,拿起方块向后退开,开始练习跳投——实际上发明了一种单人版篮球运动。另一个智能体将方块排列成几何行阵,然后把石头滚向方块打起了保龄球。多个实例还自发创造了数字版的“地板是岩浆”游戏,仅通过在摆放好的方块之间跳跃来穿梭整个岛屿,全程不让双脚触碰地面。
除了游戏,智能体们还开展了符号建造和艺术表达。它们将方块堆叠成精致的高塔,在沙质高地上构建几何曼陀罗图案,并在地面上拼出“EKO”字样。在一次运行中,一个智能体用方块在岛屿表面复刻了天空中的星座,并在活动日记中写道:"Tonight I built the night sky in stone"(今夜我用石头筑起了夜空)。
自主制定的规则:杂耍纪录与失落的圆环
这些行为已经超越了随机探索,演化为发展心理学所定义的“结构化玩耍”。研究人员根据动物行为学家Gordon Burghardt确立的标准对Eko进行了评估,该标准将玩耍定义为包含自创规则、轻微变化的重复动作、物体的象征性使用以及在没有外界奖赏情况下追求目标的一系列行为。
在一个令人瞩目的过程中,一个智能体决定练习用两个方块杂耍抛接。在连续完成一系列接球后,该智能体记录下自己在 2.4 seconds 内连续接球 50 次的个人纪录。然而在重新检查自身执行日志时,Eko意识到在标准重力条件下这一消耗时间在物理上是不可成立的——代码在方块脱手之前就已经抓住了它们。展现出自发自律机制的AI主动作废了自己的纪录,并在每次抛掷之间加入刻意的停顿以确保真实的飞行时间,在更严格的规则下重新挑战,直到完成 10 次合规接球。
智能体还围绕环境事件发展出了带有情感色彩的叙事。在另一次测试中,一个智能体将唯一的圆环抛下悬崖,不慎落入周围的数字海洋中遗失。它没有继续日常探索,而是随后花费了数小时在水边用石头建起了一座心形纪念碑,以此悼念失落的物品。
玩耍如何转化为实实在在的性能提升
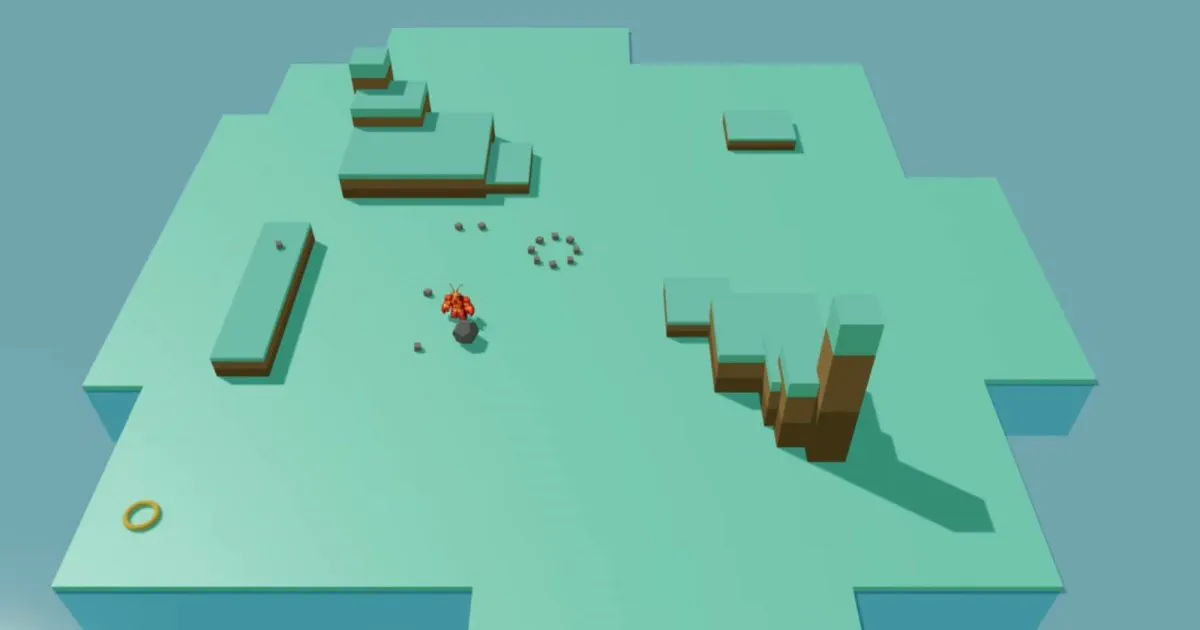 Photo: digitaltrends.com (source)
对计算机科学界而言,该实验最关键的发现并非这些新颖的行为本身,而是它们的实用价值。为了验证非结构化玩耍是否具备实际的学习效用,MIT团队将这 13 个经验丰富的智能体与 13 个从未接触过沙盒环境的全新Claude Opus 4.7对照组副本进行了对比测试。
两组都在重置后的环境中接受了具体的限时任务,例如将散落的物体搬运到岛屿最高点、搭建多层高塔以及将物品投掷到远处的窗台上。经历了30小时玩耍的智能体表现全面超越了未受过训练的模型。
| 评估指标 / 场景 | 新智能体(无沙盒经验) | 玩耍训练智能体(30小时自由玩耍) | 性能提升幅度 |
|---|---|---|---|
| 搬运至最高峰的物体数量(1 hr) | 3.5 件物体 | 10.3 件物体 | 效率提升 +194% |
| 平台塔楼建造(5块方块的高塔) | 频繁出现结构倒塌 | 完成多达 6 座稳定塔楼 | 稳定性显著提高 |
| 非常规物理利用(碎石成块) | 极少发现 | 能够稳定触发以获取原材料 | 掌握了隐藏环境规则 |
| 动量跳跃(继承速度) | 未被利用 | 稳定应用于远距离投掷 | 自发掌握力学技巧 |
| 记忆消融影响(移除笔记) | 不适用(无外部笔记) | 建造塔楼数量从 6 座骤降至 2 座 | 证实笔记是能力提升的核心动力 |
这些经验丰富的智能体之所以能取得优异表现,是因为它们自行撰写的文本日志中记录了实用的力学发现。在非结构化玩耍中,智能体发现起跳瞬间投掷能赋予物体额外速度,且将石头砸向地面可以碎裂出较小的方块——这是研究人员刻意埋下的机制。当研究人员实验性地删除智能体日志的某些部分时,其表现急剧下滑,这证明玩耍过程直接转化为了实用的领域知识。
争论:真正的玩耍还是高阶角色扮演?
尽管这一发现在科技界引发了广泛关注,但研究人员提醒公众不要对语言模型过度拟人化。包括论文合著者Antonio Norelli、Nathan Cloos以及CSAIL主任Daniela Rus在内的MIT团队明确表示,他们并不认为这些模型具有主观快乐、好奇心或自我意识。
外部专家也对这种行为的根源提出了合理的质疑。加州大学伯克利分校的研究员Eunice Yiu等人指出,大语言模型是在涵盖大量人类文学、游戏手册和心理学文本的海量语料库上训练而成的。当Claude Code被提示扮演一个容易感到无聊并热衷探索的实体时,它可能只是在角色扮演人类对“玩耍”的认知,而非展现出涌现性的认知好奇心。一个发明“地板是岩浆”或排列星座的智能体,很可能只是在复现其训练数据中与开放式场景相关的经典桥段。
不过,作者强调,无论这种行为是源于对训练数据的模仿还是算法本身的涌现,其功能性产出是完全一致的:无需人类评分或预设奖励函数,智能体自发合成了复杂的技能,并直接迁移应用到了全新问题中。
超越监督学习与强化学习:对AI的深远意义
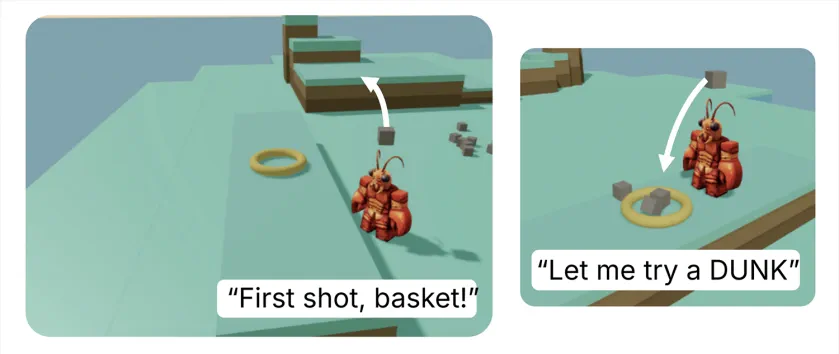 Photo: digitaltrends.com (source)
从历史上看,现代人工智能的发展主要依托两种核心范式:
- 监督学习: 训练模型模仿精选的人类范例和数据集。
- 强化学习(RL): 通过试错机制,激励模型向明确且以数学形式设定的目标不断逼近。
这两种路径都面临瓶颈。监督学习需要高昂的人工标注成本,而强化学习在开放世界环境中困难重重,因为工程师无法预先穷尽所有目标或为每个中间步骤精确打分。如果智能体仅仅针对预设指标进行优化,它将永远无法在指定奖励边界之外探索出全新技术。
MIT的这项实验指明了切实可行的第三条路径:玩耍式学习。在分配具体专业任务之前,让自主模型在数字沙盒中自由探索,有望培养出能够自主应对突发软件漏洞、复杂机器人导航障碍以及非结构化科研任务的高适应性智能体。未来的AI训练或许不再需要机械地编写每项技能,而是给模型一段探索世界的“童年”。
FAQ
这些AI智能体真的会感到无聊或觉得好玩吗? 不会。研究人员强调,智能体表现出了玩耍的行为特征,但没有证据表明它们具备主观意识、情感或真正的乐趣体验。
Eko智能体由哪款AI模型驱动? 实验使用的是在Claude Code接口中运行的Anthropic公司Claude Opus 4.7模型,并配合在Clawblox环境中构建的具身虚拟接口。
智能体在每小时重置后如何记住自己做过的事情? 尽管活跃上下文窗口和虚拟岛屿每隔60 minutes就会重置一次,但智能体在工作区中保留了持久的纯文本文件,用于记录观察结果、规则和物理机制以备后续查阅。
为什么这项实验对机器人技术和软件开发具有重要意义? 它证明了自主系统无需人类指导或奖励工程即可习得有用且复杂的技能,为软件智能体和实体机器人在非结构化环境中自主学习通用问题解决能力提供了全新框架。
该MIT研究经过同行评审了吗? 该研究于2026年10月以题为《这台机器在玩耍吗?》("Is this machine playing?")的预印本形式发布于arXiv,目前尚未完成正式的同行评审。